Anthropic, Claude Fable 5.2 ve Claude Mythos 5.2 modellerini 9 Kasım 2026 Pazartesi günü resmi duyurusuyla kullanıma sundu. Şirket iki modeli kodlama, finans ve bilim alanındaki en zorlu teknik işler için geliştirdiği en yetenekli modeller olarak tanıttı. Fable 5.2 aynı gün Pro, Max, Ultra, Team ve Enterprise planlarında, Claude Code'da ve API üzerinden kullanıma açıldı.
Claude Fable 5.2, önceki sürüm Fable 5.1'e göre yüzde 20 daha düşük fiyatla ve yüzde 30'a varan oranda daha hızlı çıktıyla geliyor. Anthropic'in paylaştığı karşılaştırma tablosunda yeni model kodlamadan robot kontrolüne uzanan testlerin çoğunda Claude Opus 5.5, GPT-6 Astra ve Gemini 4 Carbon'u geride bıraktı. Google, zeka endeksinin önceki lideri Gemini 4 Carbon modelini 28 Ekim'de tanıtmıştı.
Claude Mythos 5.2 aynı temel modeli kullanıyor; Anthropic bu sürümde siber güvenlik ve biyoloji alanındaki bazı korumaları kaldırdı ve erişimi doğrulanan kuruluşlarla sınırladı. Siber güvenlik uzmanları Cyber Verification Program'a, yaşam bilimleri araştırmacıları Life Sciences Verification Program'a başvuruyor; Fortune'ın haberine göre Claude Enterprise müşterileri modele Claude Security ürünü üzerinden ulaşıyor. Mythos 5.2, bilinen güvenlik açıklarını yeniden bulma testi CVE Rediscovery'de yüzde 89,6 başarıya ulaştı; Mythos 5.1 aynı testte yüzde 78,3 almıştı.
Claude Fable 5.2 nedir, fiyatı ne kadar?
Claude Fable 5.2, Anthropic'in 9 Kasım 2026'da yayımladığı, zorlu kodlama ve bilgi işleri için geliştirdiği en yetenekli genel kullanım yapay zeka modeli. Claude Fable 5.2'nin API fiyatı 1 milyon girdi tokenı için 8 dolar, 1 milyon çıktı tokenı için 40 dolar.
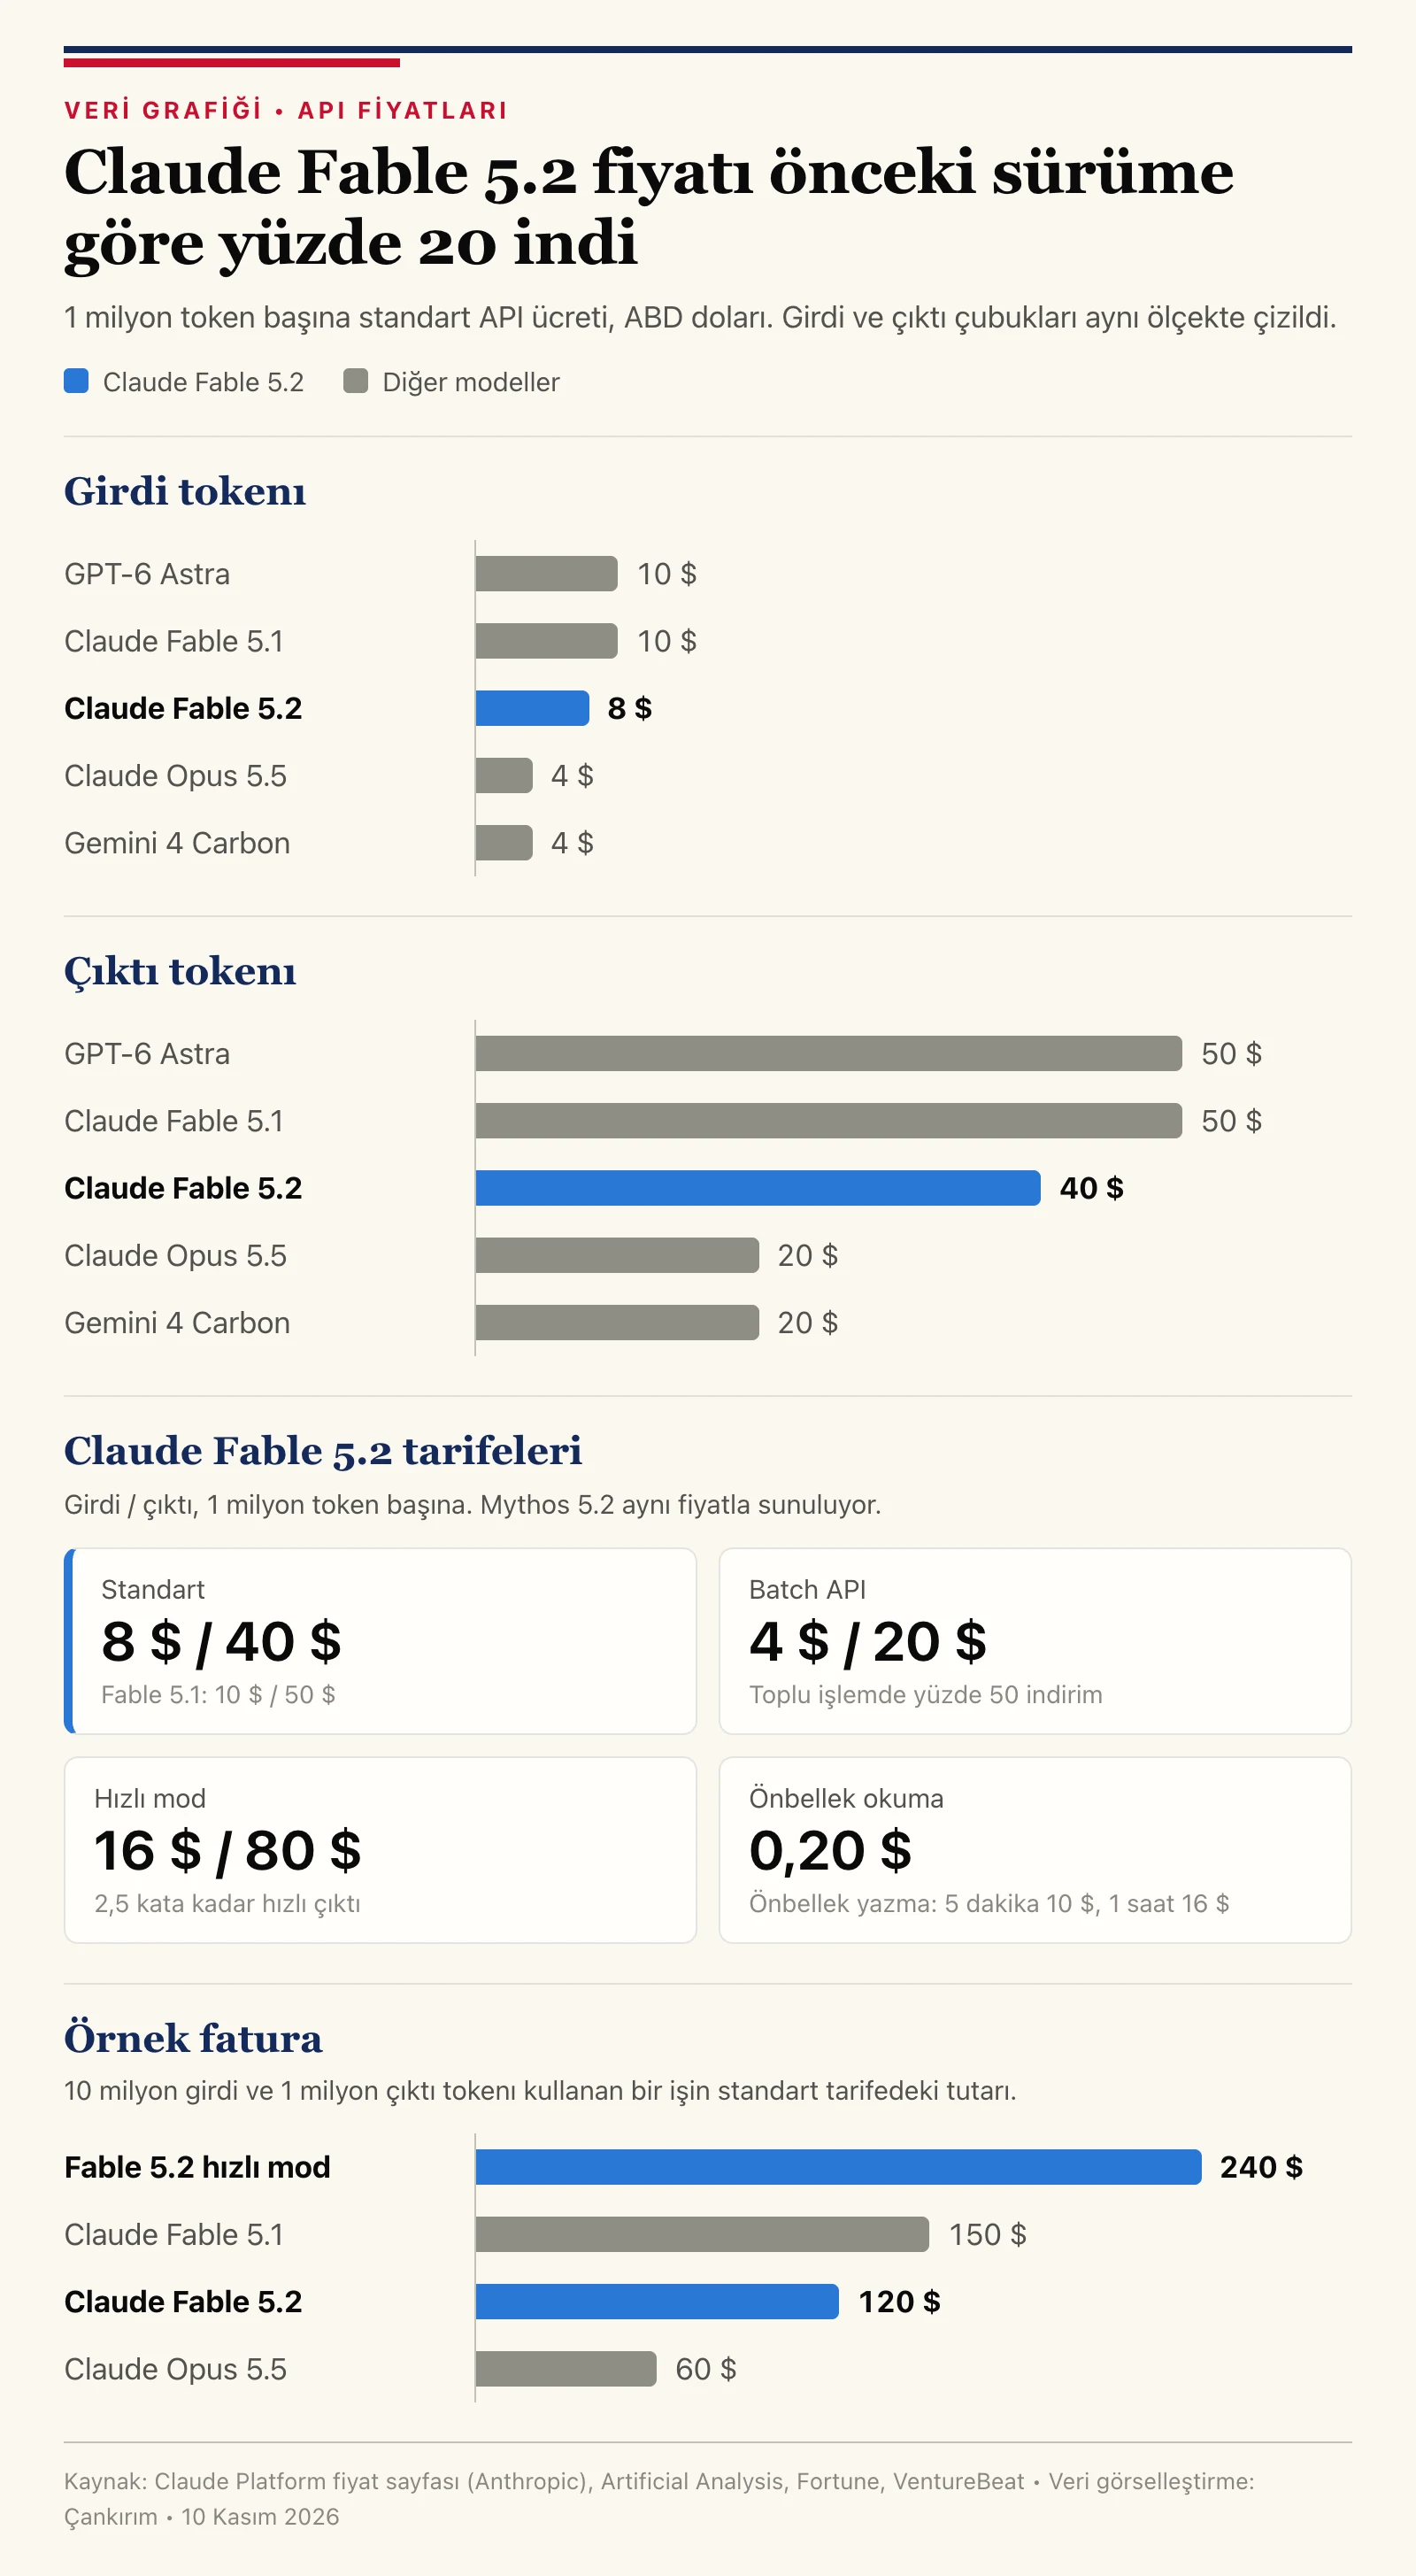
Claude Platform fiyat sayfasına göre Fable 5.2'de önbellekten okunan girdinin 1 milyon tokenı 0,20 dolara, toplu işlemlerde kullanılan Batch API ise yarı fiyatına, 4 dolar girdi ve 20 dolar çıktı ücretine geliyor. Çıktıyı 2,5 kata kadar hızlandıran hızlı mod 16 dolar girdi ve 80 dolar çıktı üzerinden ücretlendiriliyor. Fortune yeni fiyatın OpenAI'ın GPT-6 Astra modelinden yüzde 20, önbellekli girdide yüzde 80 daha ucuz olduğunu yazdı. VentureBeat'in örnek hesabında 10 milyon girdi ve 1 milyon çıktı tokenı kullanan bir iş Fable 5.1'de 150 dolar, Fable 5.2'de 120 dolar, Claude Opus 5.5 ile Meta'nın Muse Wonder modelinde 60 dolar tutuyor.
| Model | Girdi (1 milyon token) | Çıktı (1 milyon token) | Önbellek okuma (1 milyon token) |
|---|---|---|---|
| Claude Fable 5.2 | 8 dolar | 40 dolar | 0,20 dolar |
| Claude Mythos 5.2 | 8 dolar | 40 dolar | 0,20 dolar |
| Claude Fable 5.1 | 10 dolar | 50 dolar | 0,25 dolar |
| Claude Opus 5.5 | 4 dolar | 20 dolar | 0,20 dolar |
| GPT-6 Astra | 10 dolar | 50 dolar | 1,00 dolar |
| Gemini 4 Carbon | 4 dolar | 20 dolar | 0,20 dolar |
Claude Fable 5.2 özellikleri ve Fable 5.1'e göre yenilikler
Anthropic'e göre Fable 5.2 belirsiz mühendislik işlerini günlerce sürdürüyor ve binden fazla alt ajanı aynı anda yönetiyor. Bir Anthropic mühendisinin deneyinde model boş bir klasörden başladı, sekiz gün boyunca binden fazla alt ajanla kod yazdı ve dizüstü bilgisayarda açılan bir prototip işletim sistemi üretti. Yaklaşık bin Fable 5.2 ajanı Fermat'nın Son Teoremi'nin ispatını 30 saatte Lean ispat diline aktardı; aynı iş daha önceki bir Claude araştırma sürümüyle 11 gün sürmüştü.
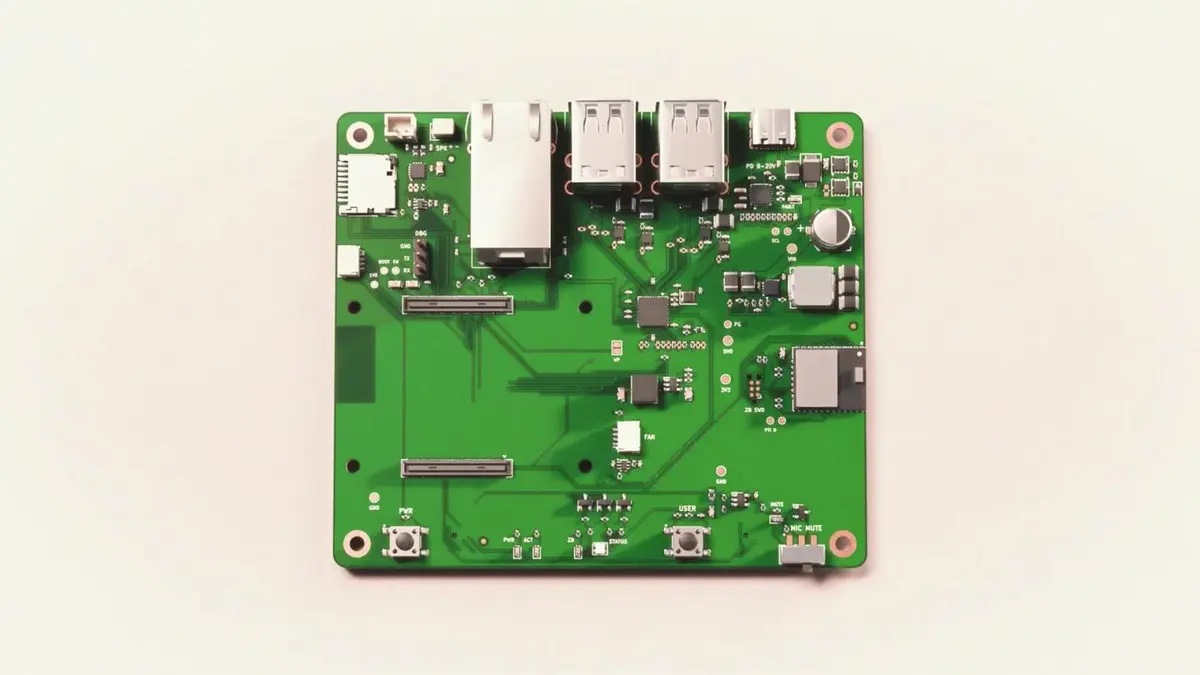
Model tek paragraflık bir istemle ev tipi sesli asistan, USB konferans hoparlörü ve elde taşınan sanal evcil hayvan olmak üzere üç çalışan cihazı devre kartı, kasası ve yazılımıyla tasarladı. Robot kontrolünü ölçen RoboDojo Sim testinde başarı oranı Fable 5.1'deki yüzde 27,6'dan yüzde 64,9'a çıktı. Fable 5.2'de siber güvenlik ve biyoloji sınıflandırıcılarına takılan sorgular Opus 4.8 ve Opus 5 modellerine yönlendiriliyor; Anthropic bu engellemelerin Fable 5.1'e göre yaklaşık yüzde 55 azaldığını bildirdi.
Claude Fable 5.2, GPT-6 Astra ve Gemini 4 Carbon karşılaştırması
Artificial Analysis ölçümünde Claude Fable 5.2 en yüksek çaba düzeyinde 65 puanla Zeka Endeksi'nin ilk sırasına yerleşti; Gemini 4 Carbon 60, Claude Opus 5.5 59, GPT-6 Astra 57 puanda kaldı. Anthropic'in tablosunda Fable 5.2 kodlama testi FrontierSWE v2'de yüzde 69,9, bilgisayar kullanımı testi OSWorld 2.1'de yüzde 89,3 ve bilimsel araştırma testi Terminal-Bench-Science 0.1'de yüzde 74,6 ile dört model arasındaki en yüksek puanı aldı.
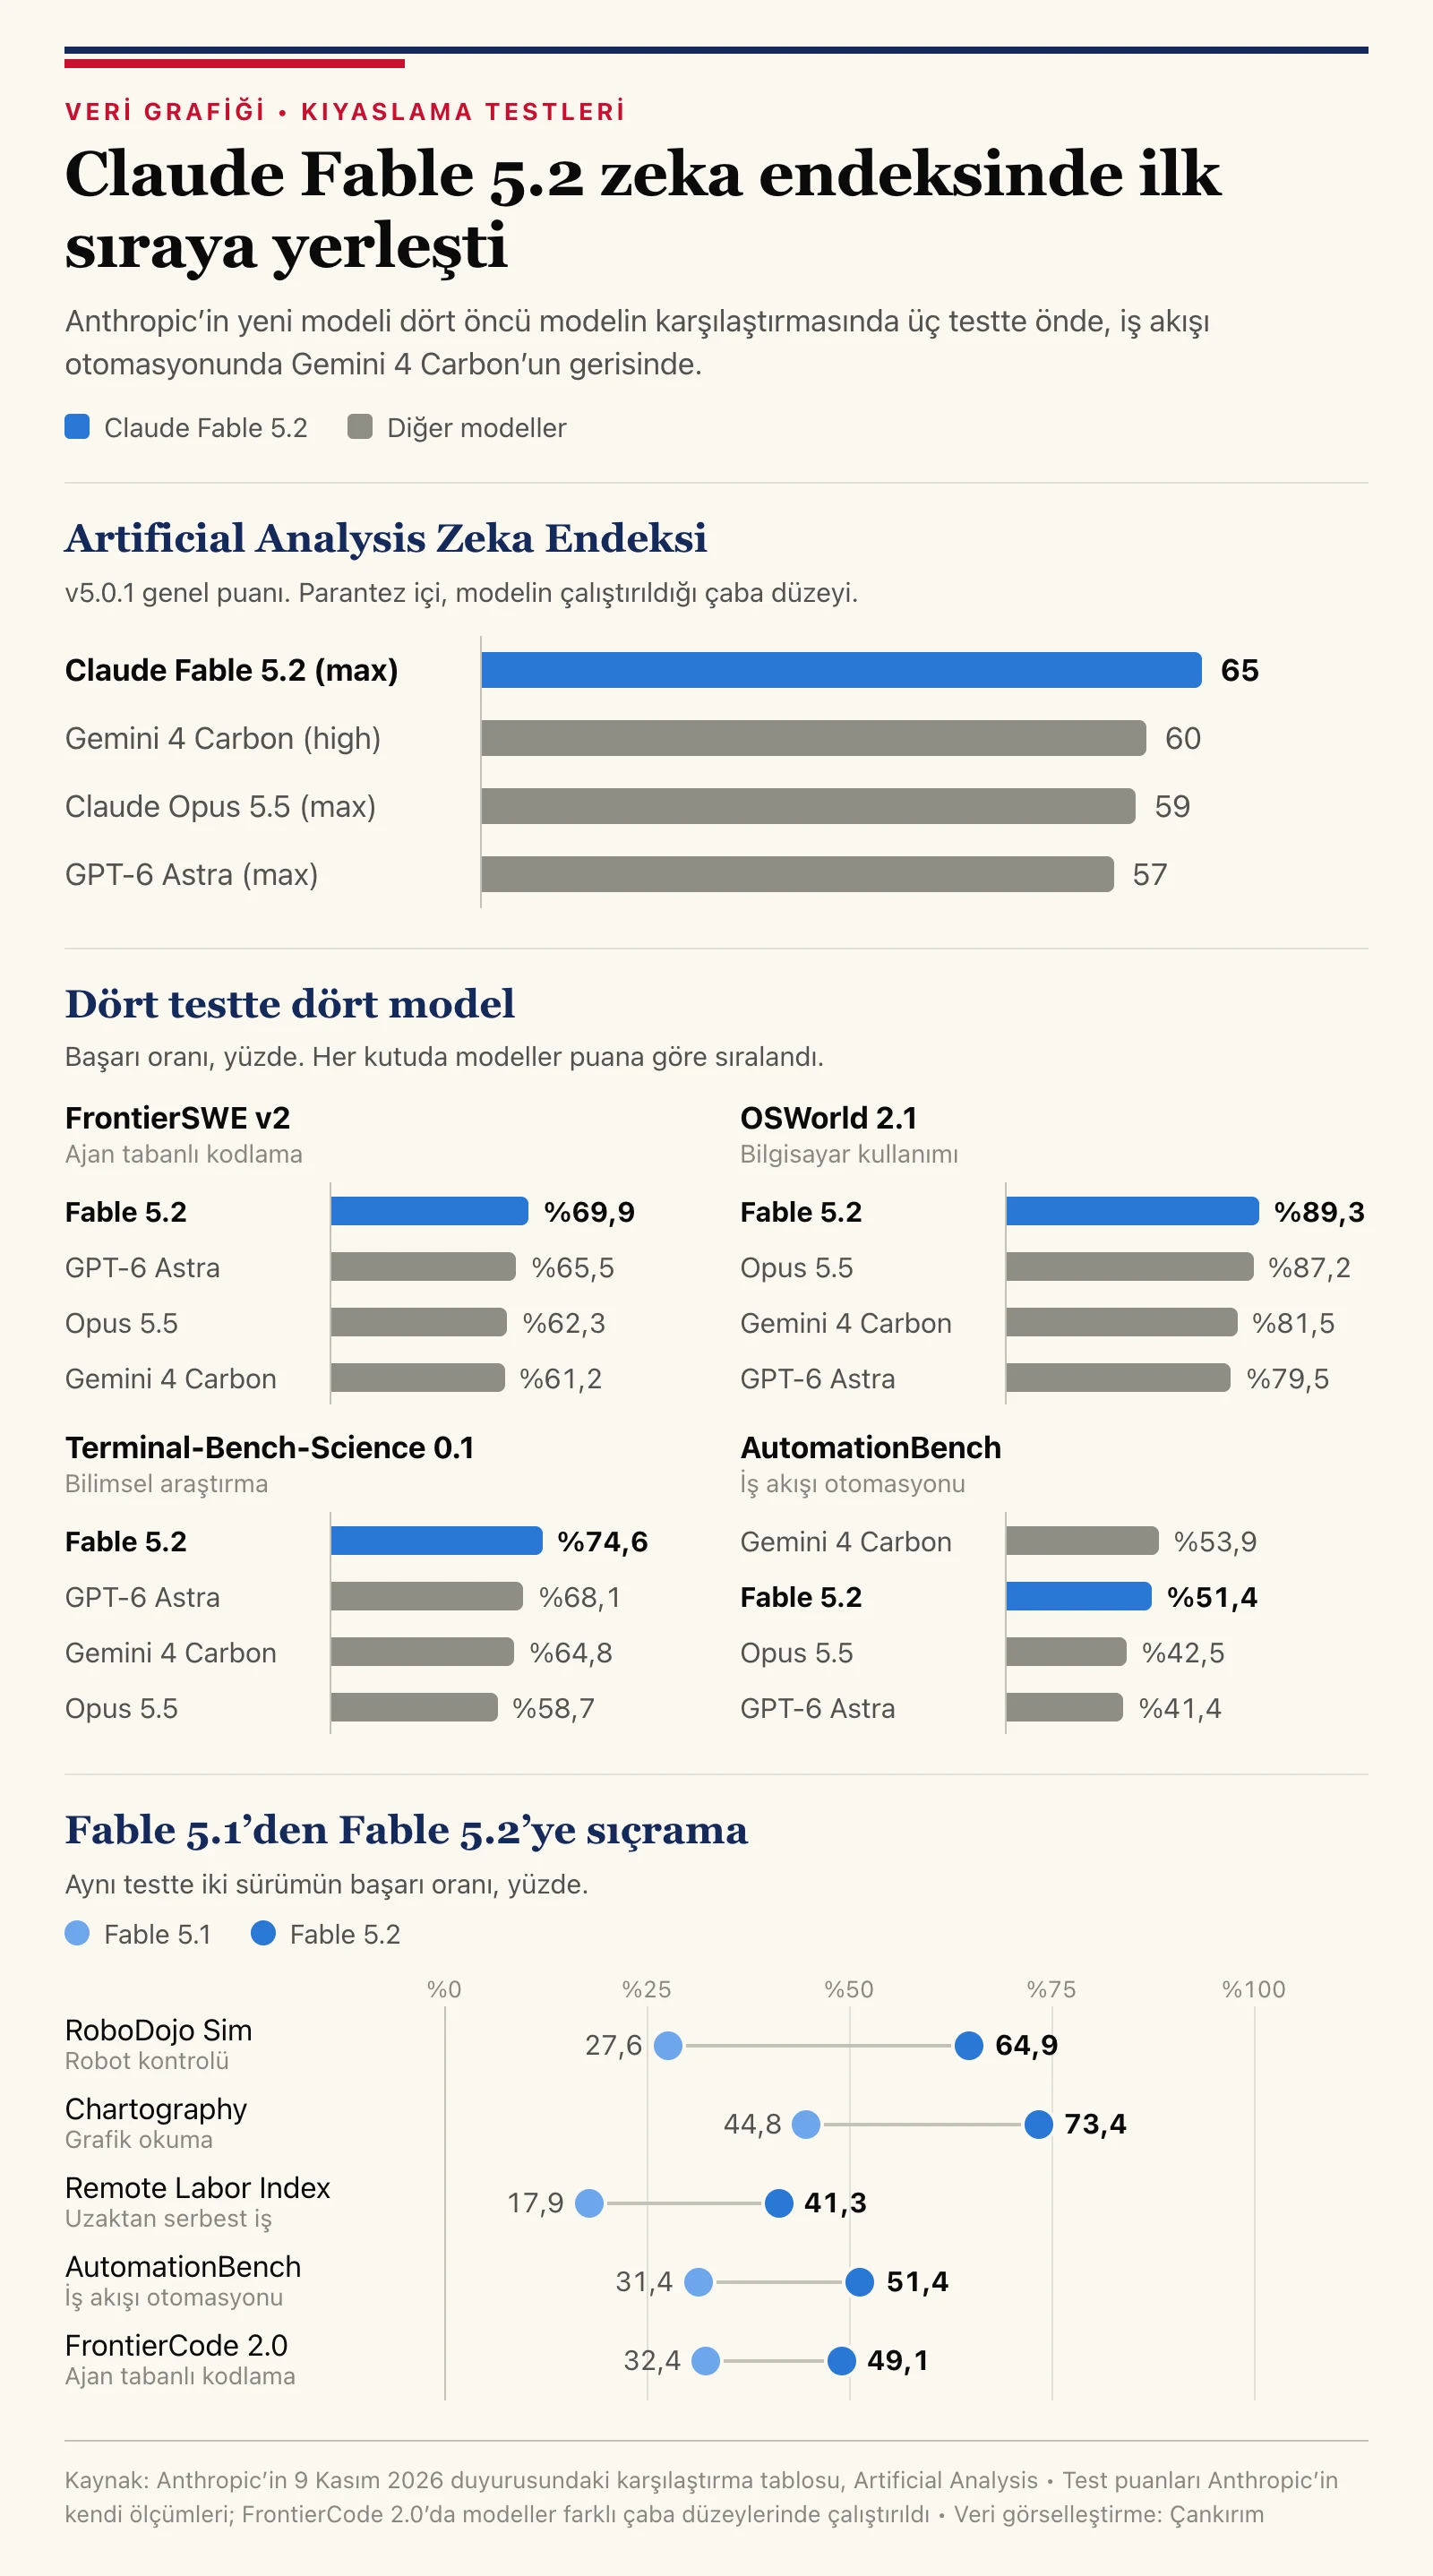
Yeni model her testte önde değil; iş akışı otomasyonunu ölçen AutomationBench'te Gemini 4 Carbon yüzde 53,9 ile Fable 5.2'nin yüzde 51,4'lük sonucunu geçti. Artificial Analysis verilerinde Fable 5.2 en yüksek çaba düzeyinde görev başına 26,54 dolara mal oluyor; aynı ölçüm Claude Opus 5.5 için 10,04 dolar, Gemini 4 Carbon için 7,76 dolar gösteriyor. VentureBeat test sonuçlarının Anthropic'in seçtiği ölçümlere dayandığını hatırlattı; Anthropic de gündelik kodlama ve bilgi işleri için daha ucuz olan Claude Opus 5.5'i öneriyor.
Buna karşılık Google cephesinin amiral gemisi uzun bağlam, siber savunma ve birim maliyet dengesinde üstünlüğünü korudu. Fiyat makası yarı yarıya açıldı. Tek seferde 1 milyon token işleyen mimari, GraphWalks uzun bağlam testinde yüzde 96,2 ve SEC-bench Pro zafiyet tespitinde yüzde 88,2 skor üretirken standart API tarifesinde 4 dolar girdi ve 20 dolar çıktı ücretiyle çalıştı. Sundar Pichai'nin 28 Ekim'de paylaştığı Google Gemini 4 Carbon özellikleri ve GPT-6 Astra karşılaştırması da 15 ayrı kıyaslama testinin tüm kırılımlarını ortaya koydu.
| Test | Claude Fable 5.2 | Claude Fable 5.1 | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| Genel: Artificial Analysis Zeka Endeksi | 65 | — | 59 | 57 | 60 |
| Kodlama: FrontierCode 2.0 | %49,1 (Xhigh) | %32,4 (Xhigh) | %45,5 | %42,8 | %41,1 (Medium) |
| Kodlama: FrontierSWE v2 | %69,9 | %56,3 | %62,3 | %65,5 | %61,2 |
| İş akışı: AutomationBench | %51,4 | %31,4 | %42,5 | %41,4 | %53,9 |
| Bilimsel araştırma: Terminal-Bench-Science 0.1 | %74,6 | %52,6 | %58,7 | %68,1 | %64,8 |
| Bilgisayar kullanımı: OSWorld 2.1 | %89,3 | %83,5 | %87,2 | %79,5 | %81,5 |
| Robotik: RoboDojo Sim | %64,9 | %27,6 | %39,4 | %29,8 | — |
| Bilgi işi: AA-Briefcase v1.1 | %66,1 | %61,5 | %61,2 | %52,0 | %61,8 |
| Bilgi işi: Remote Labor Index | %41,3 | %17,9 | %21,3 | %20,8 | — |
| Akıl yürütme: Humanity's Last Exam | %74,2 | %65,6 | %67,7 | %57,2 | — |
| Grafik okuma: Chartography | %73,4 | %44,8 | %64,4 | %71,0 | %72,5 |
Kaynaklar: